开发语言未说明
资源大小13.18MB
运行环境Linux / Web
资源状态可查看
从参考语音到目标音色
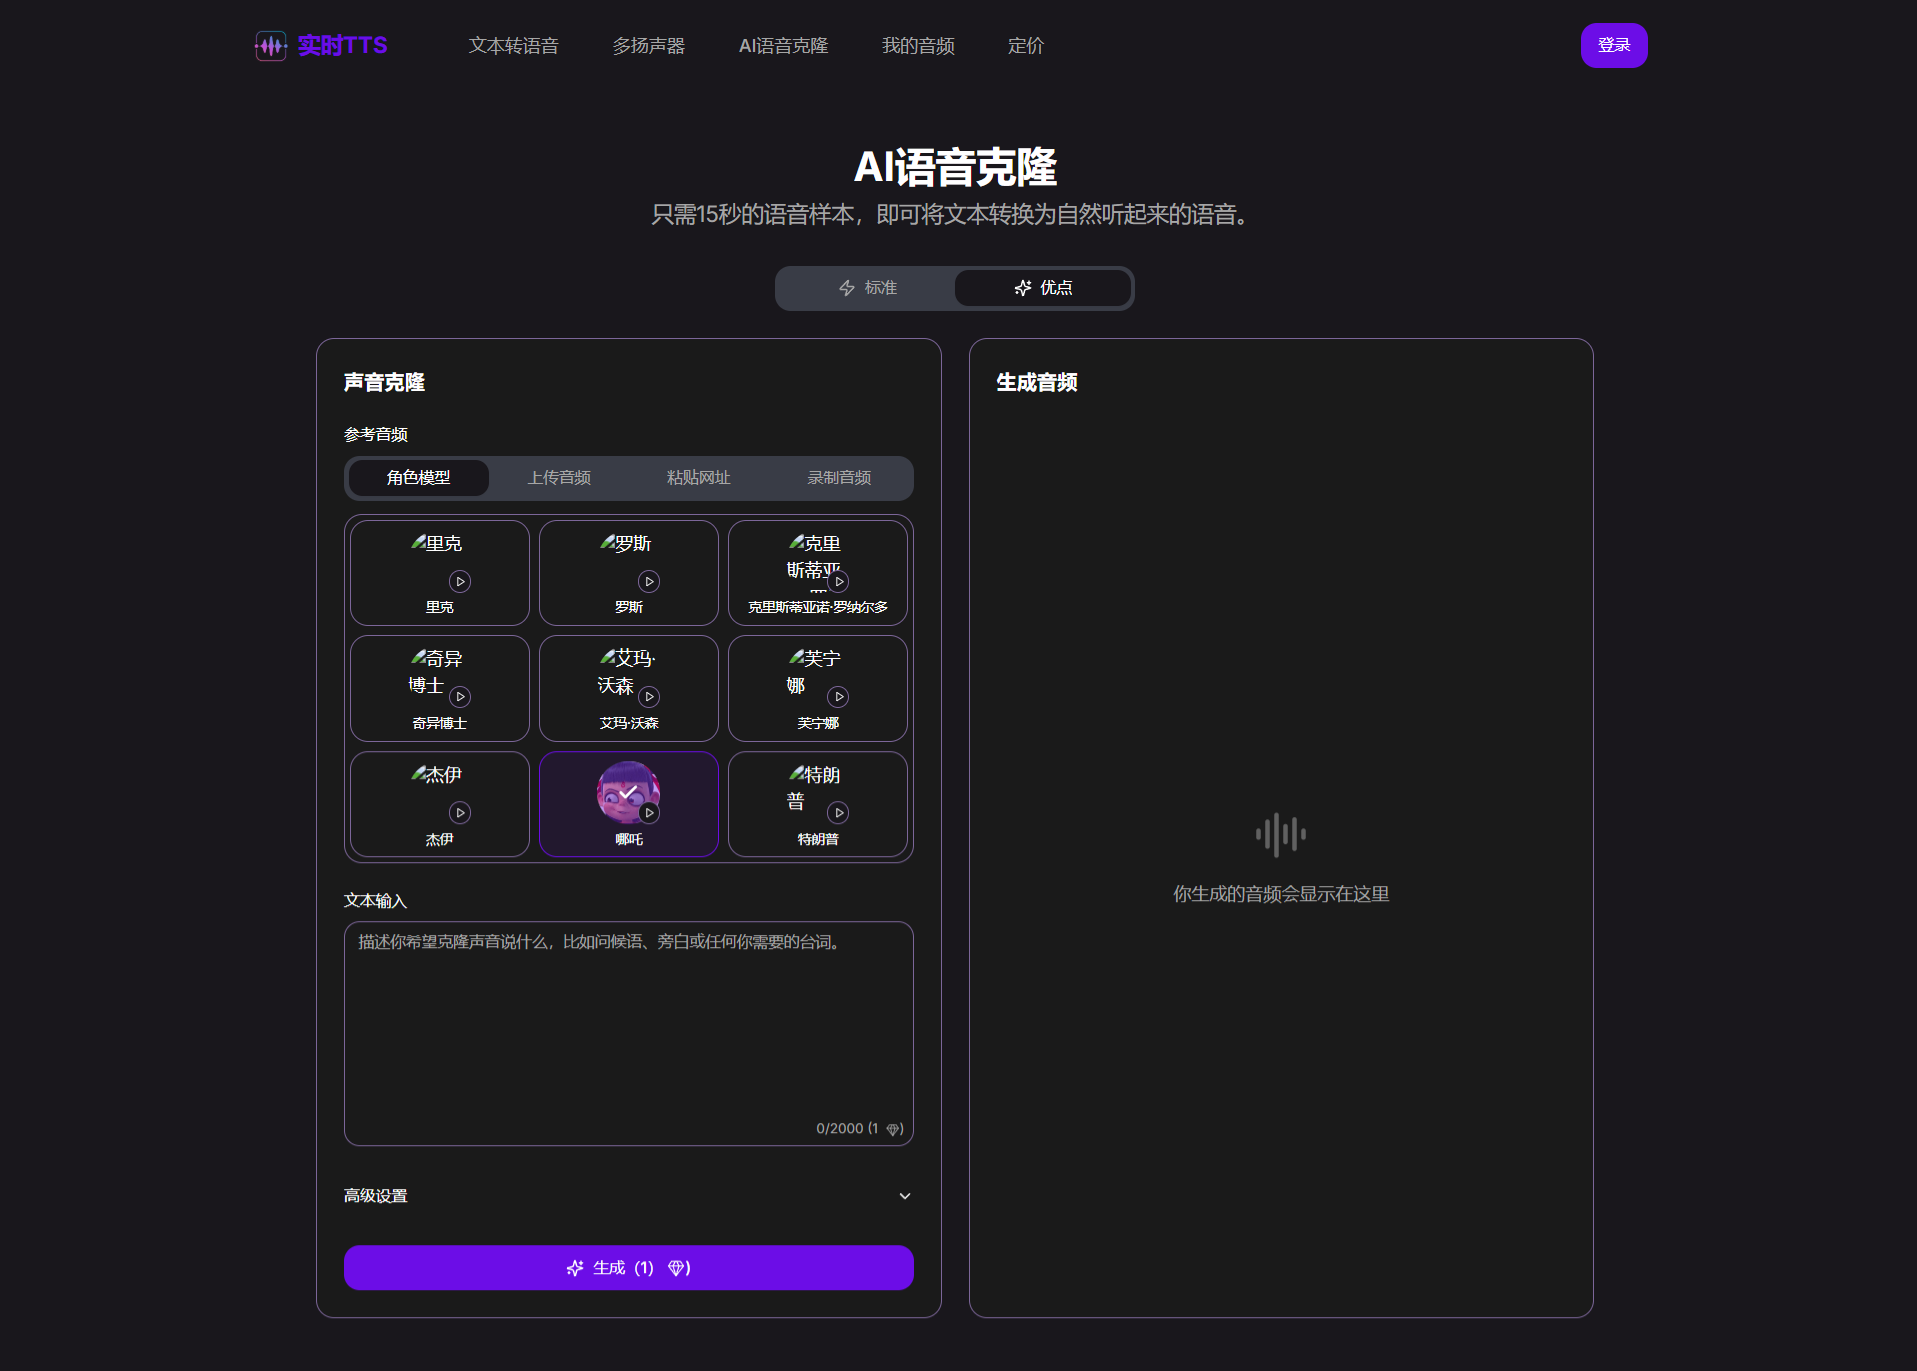
只要提供一小段参考语音,F5-TTS 就能模仿说话人的音色完成合成。这一能力让它在还原特定音色、生成带有自然节奏和韵律的语音时更有优势。
语音合成之外,它还能处理多语言内容,并支持一定程度的语言混说;生成语音的整体时长或语速也可以调节。
架构取舍与生成表现
F5-TTS 属于开源深度学习文本转语音系统,采用 Flow Matching 与 Diffusion Transformer 架构,设计上追求在模型相对简洁的前提下输出高质量、多语言语音。
它并不依赖复杂的传统 TTS 流程,目标仍是自然语音生成,因此在开源社区中获得了较多关注和实际应用。
本地部署与开发接入
研究人员和开发者可以将其用于实验、二次开发或本地部署。使用方案覆盖 Python 包、Gradio 界面和 Docker 镜像,论文、代码与模型检查点也已公开。
项目运行平台为 Linux / Web,资源大小 13.18MB。
界面预览